GPU 上的高速嵌入推論
本文深入探討 Perplexity 針對此類特殊模型所打造的底層推論服務基礎架構。
快速且精準的搜尋對 Perplexity 的各項產品至關重要——從 Search、Computer 到我們的 API 平台皆是如此。在幕後,最核心繁重的運算工作由嵌入(embedding)與排序(ranking)模型承擔,它們協助我們的系統針對給定的查詢找出最相關的結果。我們透過自行訓練並部署服務自研模型(例如 pplx-embed),達到了業界頂尖的品質與延遲表現。
本文將深入揭露 Perplexity 針對這類特殊模型所構建的底層推論服務基礎架構。我們將探討如何高效滿足 AI 原生搜尋的推論需求,在支援 EB 級(exabyte-scale)搜尋索引的同時,實現模型的快速原型設計與評估。這些技術共同拓展了搜尋品質與效率的柏拉圖前沿(Pareto frontier),使我們能以最低的成本與延遲,為各類 Agent 與使用者提供最佳的搜尋結果。
用於搜尋的嵌入模型(Embeddings for Search)
在典型的搜尋架構中,被索引的文檔會透過嵌入模型映射至高維度向量空間,並儲存於向量資料庫中。當透過相同模型對查詢(query)進行向量嵌入後,便能藉由尋找與查詢向量最接近的文檔向量來定位相似文檔。這使得推論引擎需要因應兩種截然不同的流量模式:
- 批次嵌入(Batch Embedding):在建立、擴充或重新索引資料庫時,需要將大量文檔批量嵌入至向量空間中,此時需最大化吞吐量以降低成本。
在向量搜尋完成後,大量文檔批次必須進行評分(scoring),這需要在吞吐量與延遲之間取得平衡。
- 即時線上嵌入(Online Embedding):當使用者查詢資料庫時,簡短的查詢必須立即轉換為嵌入向量以進行檢索,此時需極小化延遲。
我們在建構推論基礎架構時,盡可能跨不同應用場景復用通用組件。由於我們通常使用較小型的 Transformer 模型來產生嵌入向量,因此大部分實作都與我們的大語言模型(LLM)推論程式碼共用:批次嵌入類似於受限於運算能力的預填階段(compute-bound prefill),而通常僅有少數 token 的即時線上嵌入,在運算特性上則類似於受限於記憶體頻寬的解碼階段(memory-bound decode)。因此,我們復用了針對 LLM 所優化的 prefill 與 decode 運算核心來支援嵌入模型。如此一來,我們只需極少的額外工程工作,就能實現龐大的批次推論吞吐量,同時確保線上即時嵌入工作負載具備極低的延遲。
Tulip、ROSE 與 Ivy 架構
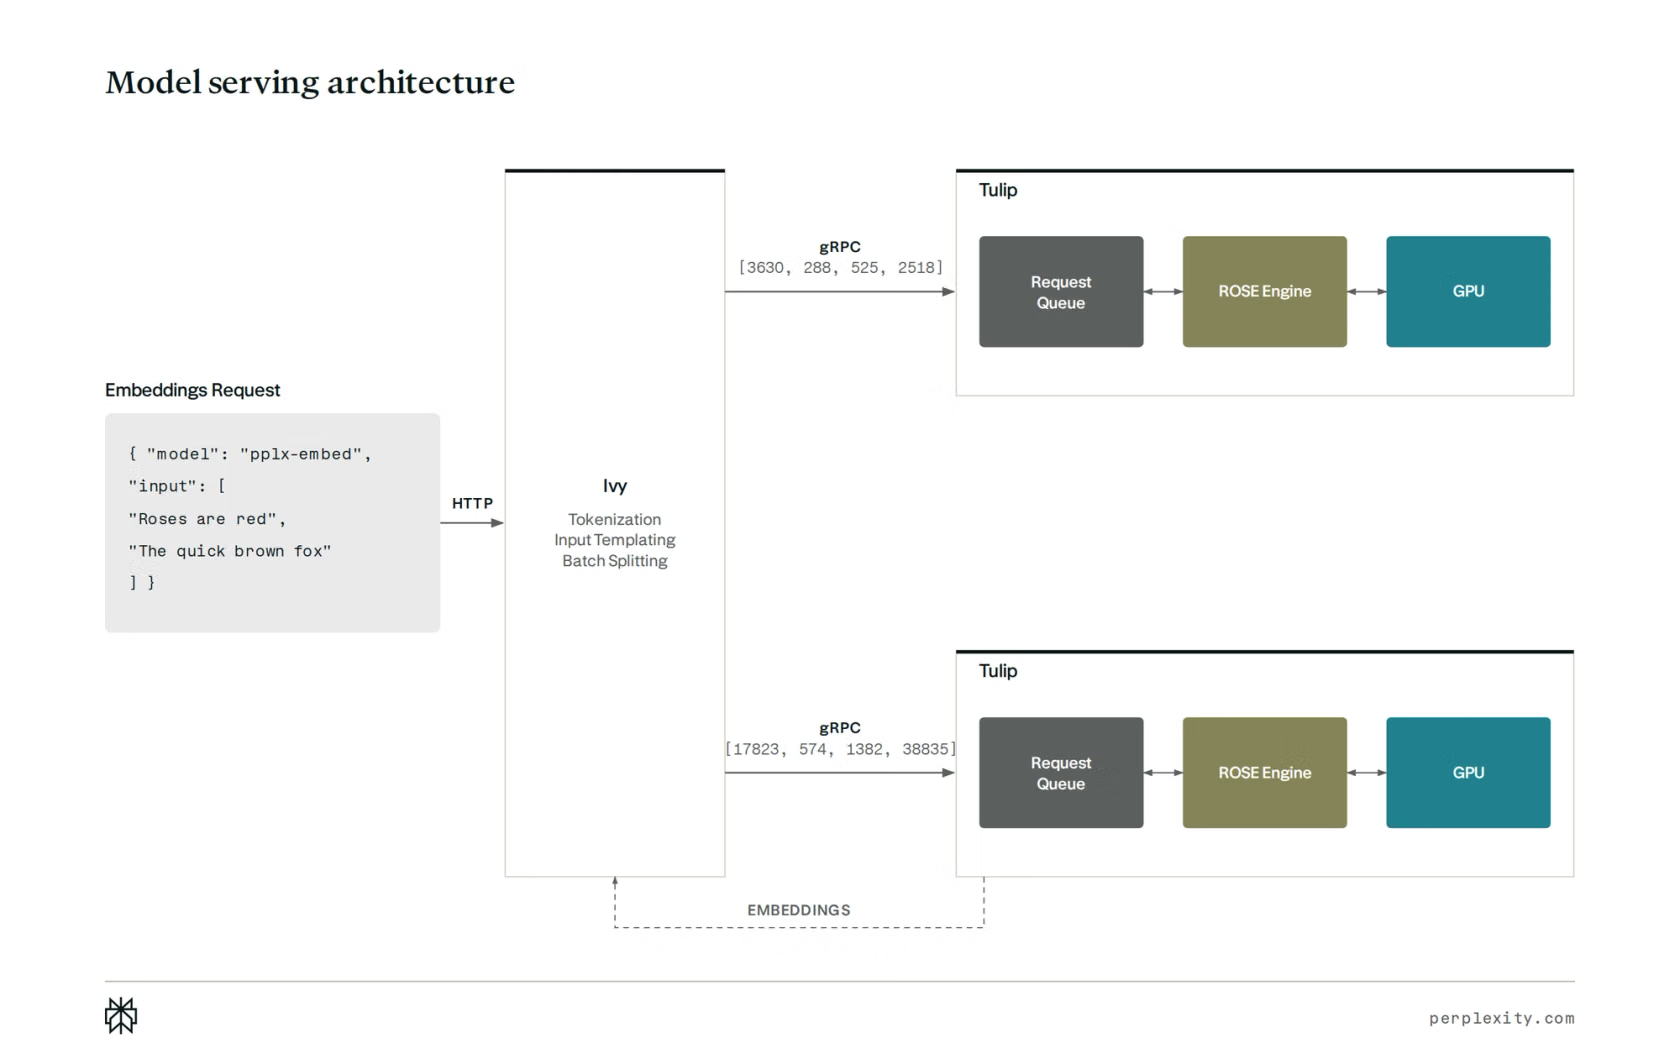
我們透過標準化 API 在內部以及透過 API 平台對外提供推論服務。在系統底層,有多個服務協同參與處理一個嵌入請求:
- Ivy 是一個以 Rust 編寫的 HTTP 閘道器(Gateway),由 Perplexity 各項服務所呼叫。
它負責處理請求在 CPU 端的各項前置工作,例如 JSON 解析、Token 標記化(tokenization)、輸入模板套用與批次切分,並將請求轉換為下游伺服器專用的自訂 gRPC 協定。這樣的職責分離使我們能夠靈活調整 token 化與輸入格式化相關參數,而無需變動負載較重的推論實例。
- Tulip 是推論伺服器的介面層。
它是一個採用 Rust、tokio 與 tonic 實作的 gRPC 伺服器。Tulip 接收 gRPC 推論請求,負責排程(scheduling)與批次打包(batching)。隨後將批次傳送至 ROSE 引擎,並將處理完成的回應回傳給客戶端。
- ROSE(Runtime-Optimized Serving Engine,執行期優化服務引擎)負責模型推論的具體實作。
它主要由 Python 定義,為各種類型的模型提供運算核心(kernels)、網路層(layers)與模型定義。ROSE 實作了模型的前向傳播(forward pass),並提供了專為嵌入模型特化的 CUDA 圖(CUDA Graph)管理機制。它透過 step() 函式與 Tulip 對接,該函式接收一個批次,並回傳對加速器(GPU)上運算作業的引用。
超越運算核心的架構優化(Paying Attention Beyond the Kernel)
無論是以 Transformer 為基礎的模型,或是底層的 Hopper/Blackwell 硬體架構,皆已是相當成熟的技術,因此在各類推論引擎中,GPU 端的嵌入推論大多已收斂至高度最佳化的實作。即便如此,我們仍在將模型端到端呈現給客戶端的執行期(runtime)與驅動架構中,發現了進一步提升效能的契機。特別是,我們發現透過細緻管理 CUDA 圖(CUDA Graphs),並建立 LazyTensor 抽象層在原生 Rust 引擎中非同步追蹤 GPU 端運算結果,能大幅改善延遲表現。我們在 Tulip 中實作了這些特性,使其能高效與 ROSE 的模型實作進行對接。
Tulip
我們將 Tulip 設計為模型服務之上極度輕量化的介面層。它在 Tokio 非同步任務中處理連入的請求,維護一個請求池,並從中排程組裝批次以派發至加速器。Tulip 的排程機制非常直觀:當 Tulip 正在派發工作或等待結果時,連入請求會暫存累積。隨後系統會依先到先服務(FCFS)原則,從累積的請求中選取序列送入模型執行。
採用這種簡潔排程機制的原因,源自於我們對模型效能特性的觀察。對於小型嵌入模型而言,在我們服務的序列長度範圍內,密集層(dense layers)的線性開銷遠大於注意力機制(attention)的二次方開銷。因此,推論延遲基本上與 Token 的總數成正比,而非與序列(sequence)數量相關。其結果是,一旦批次大小足以讓 GPU 飽和(對於參數量低於 10 億的模型約為 512 個 token),在批次中塞入更多序列並無法進一步提高效率。
為了高效與模型對接,Tulip 仰賴 CUDA 圖(CUDA Graphs)與惰性結果追蹤(lazy result tracking),使 GPU 與 CPU 的運算相互重疊(overlap),充分榨乾可用硬體資源。
CUDA 圖管理(CUDA Graph Management)
執行模型的前向傳播涉及 CPU 端與 GPU 端的共同作業。CPU 負責排程批次並使用適當參數啟動核心,而 GPU 則執行相應的矩陣乘法、注意力機制、正規化(norm)或激勵函數(activation)核心。對於諸如訓練或重新索引等高吞吐量負載,CPU 端的開銷通常微不足道,因為批次尺寸較大且 GPU 端耗時較長。然而,在較小的批次尺寸下,CPU 端的工作開銷往往會超過 GPU 端的運算時間。
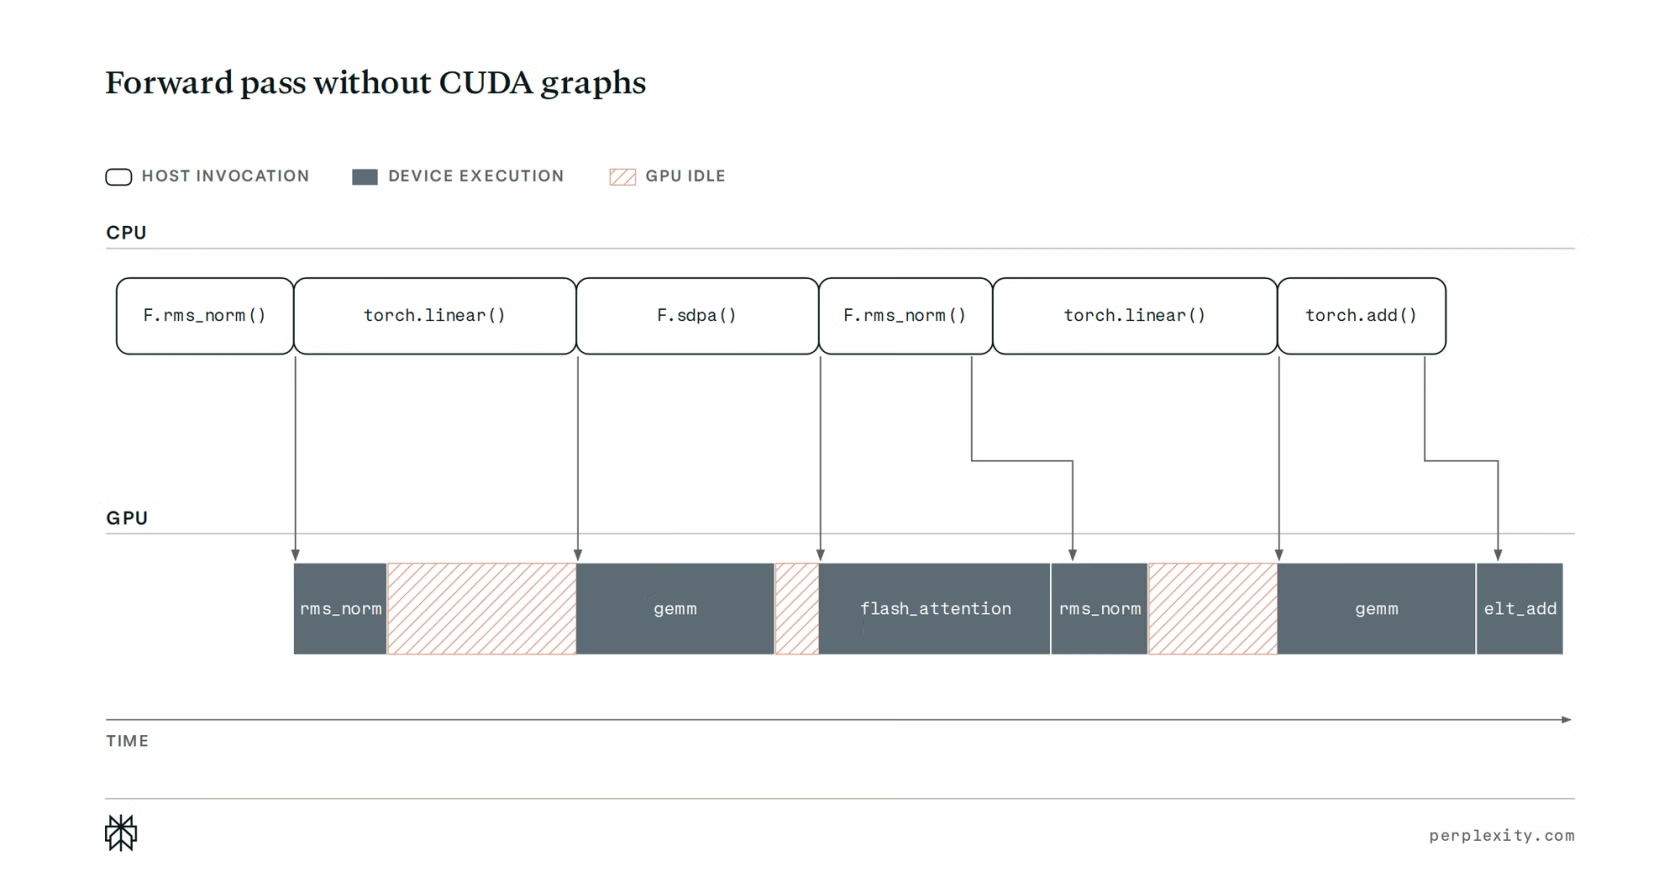
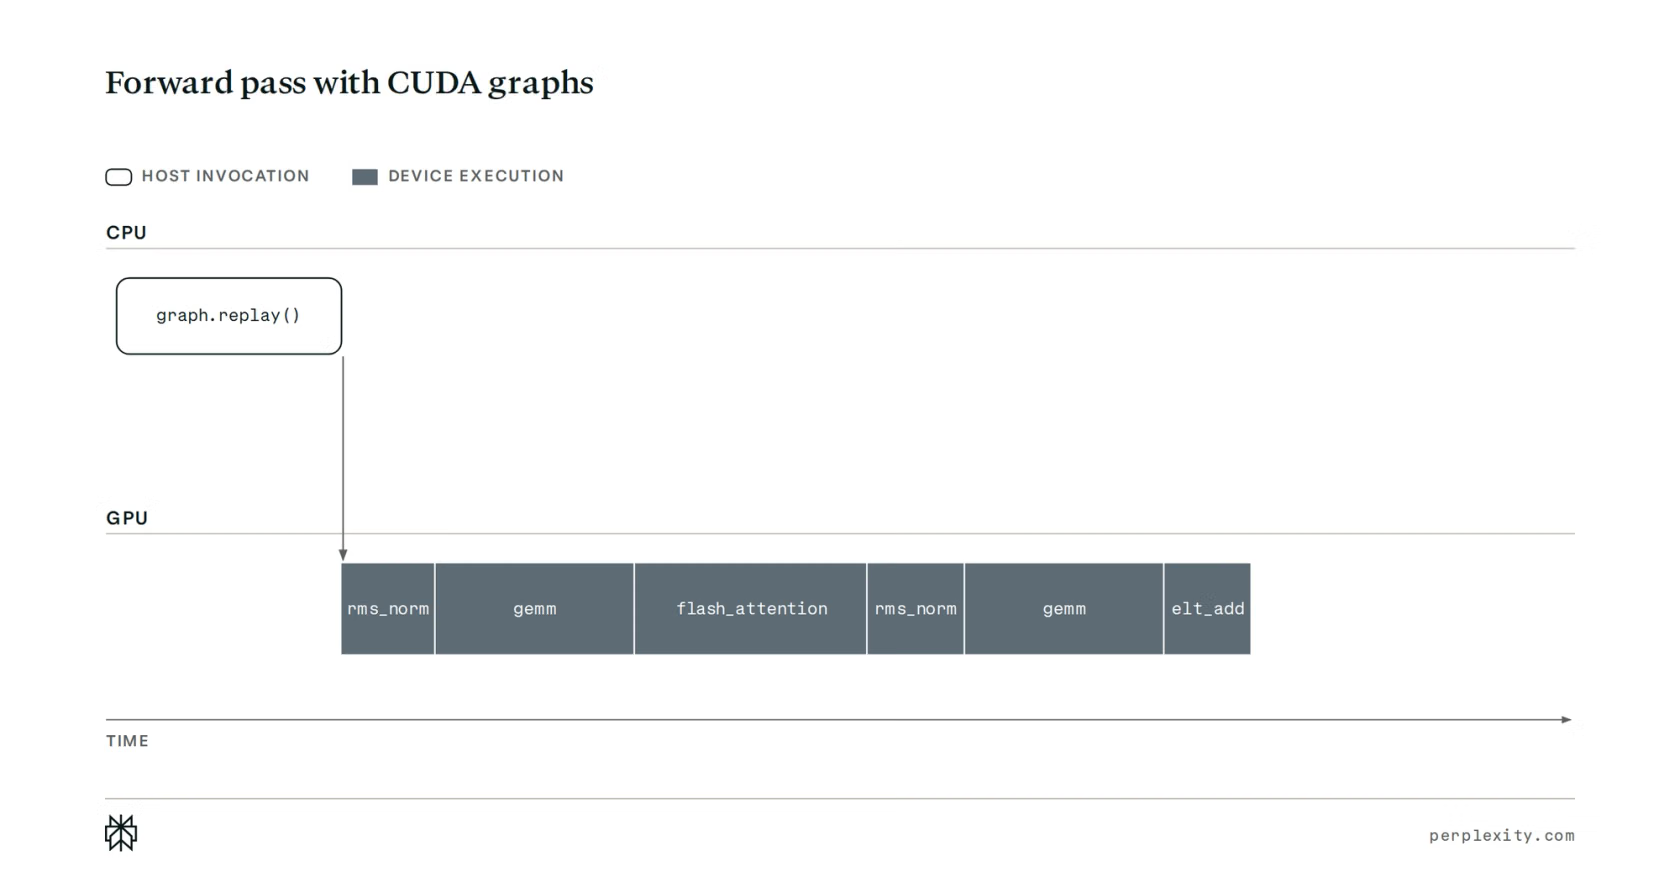
為了消除這些額外開銷,我們可以構建 CUDA 圖(CUDA Graph)來擷取前向傳播中啟動所有核心所需的中繼資料,並透過對 CUDA 驅動程式的單次呼叫完成啟動,而非逐一獨立啟動各個核心。針對已擷取 CUDA 圖的組態配置,這完全免去了重複執行代價高昂的 Python 與 PyTorch 程式碼的需求。
我們針對每個模型追蹤其反曲點(inflection point),用以判定 GPU 執行耗時何時會大於 CPU 端的核心啟動開銷。由於嵌入模型規模較小,我們觀察到此反曲點出現在數千個 token 與數十個序列組成的批次處。部分注意力機制的實作仰賴動態主機端輸入來配置核心啟動,這阻礙了全模型 prefill/dense CUDA 圖的捕獲。我們向相關運算核心專案提交了 upstream 變更,以在我們的推論引擎中啟用全圖捕獲支援。
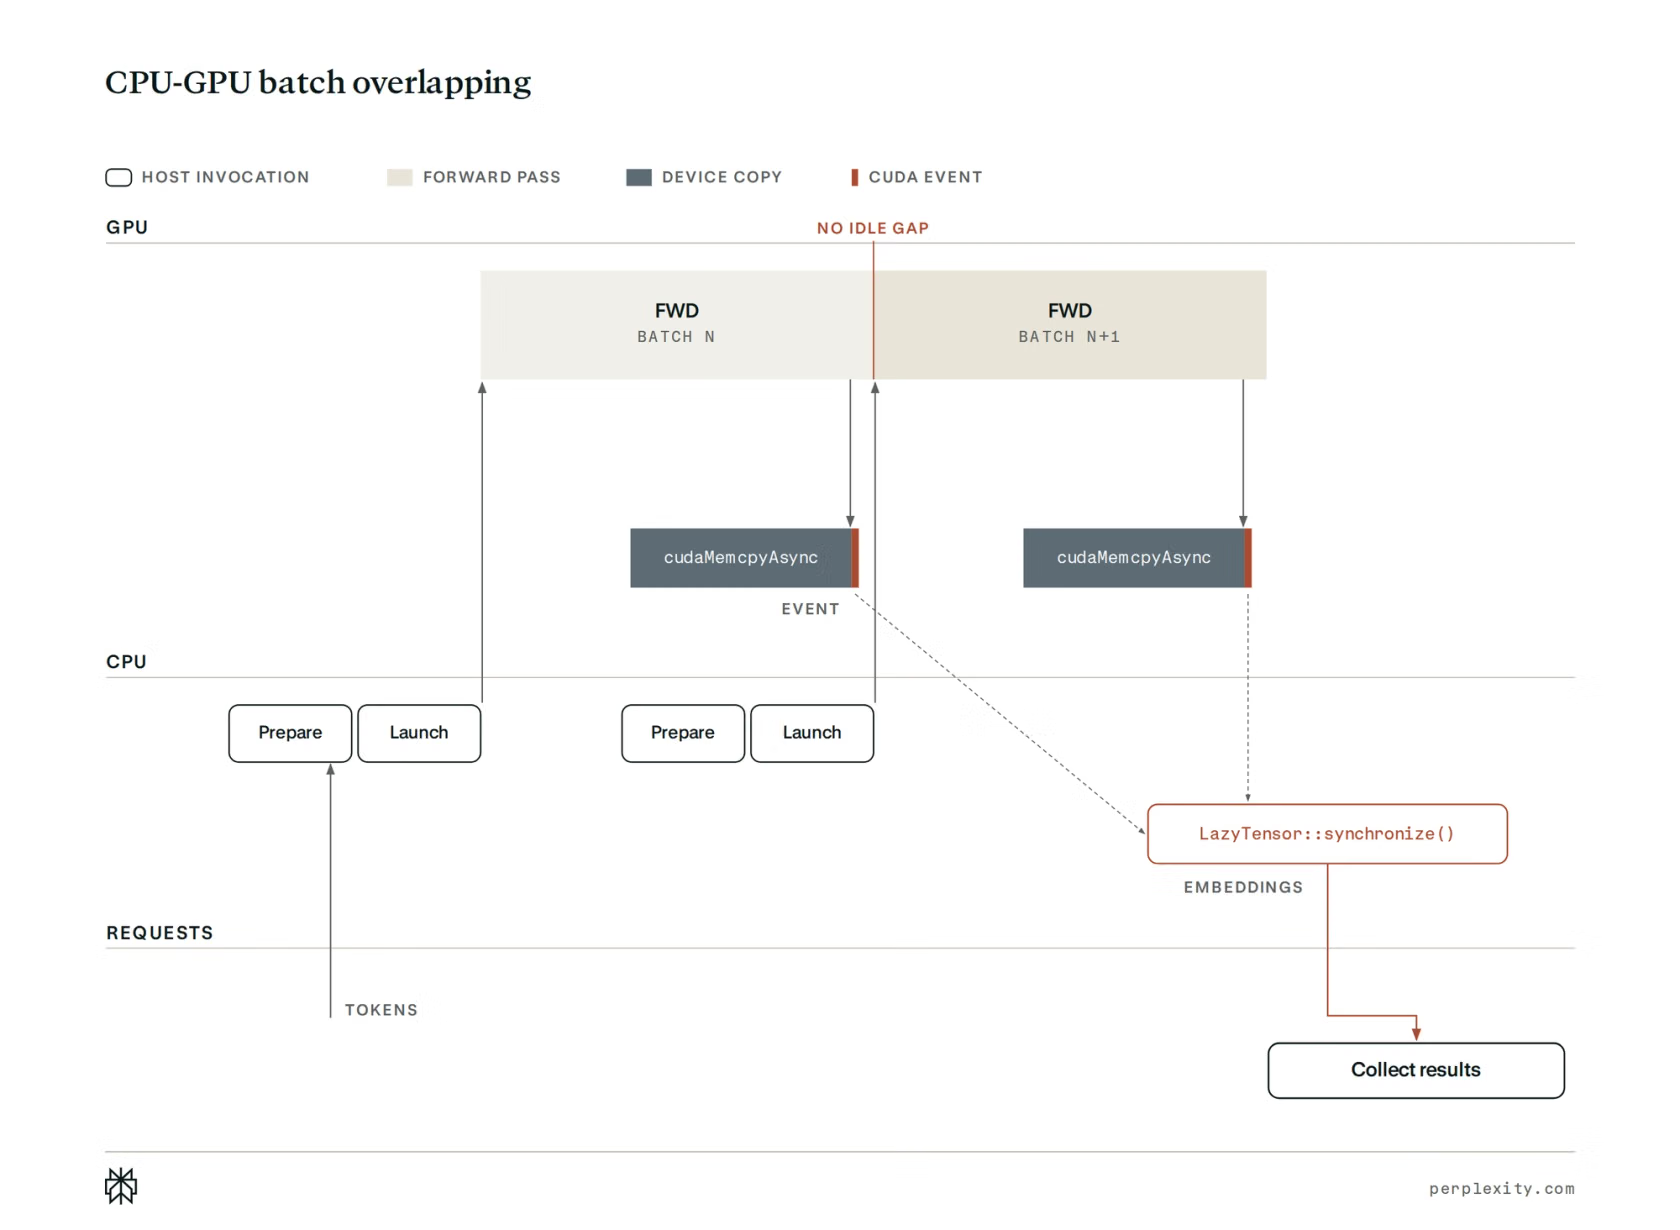
為徹底解決開銷問題,我們為所有嵌入模型構建全模型 CUDA 圖,並實現 CPU 工作與 GPU 運算的重疊並行。由於 CUDA 圖將 CPU 端開銷降至極致,一旦啟動圖執行,CPU 便能立即騰出時間來啟動並排入下一個批次的執行佇列。待處理批次的運算結果由 LazyTensor 追蹤,它允許 Rust 中的非同步任務等待直到前一個批次執行完畢。CUDA 圖確保系統不受核心啟動成本牽制,大幅提升低延遲服務能力;在高吞吐量場景下,也因 CPU 能更快為下一個批次做準備,進一步優化了排程效率。
CUDA 圖必須針對每種獨立的組態分別進行捕獲,對於嵌入模型而言,這意味著每個序列數與 token 數的組合都需要一張圖。由於這個網格維度極其龐大,我們將 token 數填充(padding)為 64 或 256 的倍數分桶(bucket)。即便如此,針對典型模型仍會產生數千張圖,完全捕獲可能需要耗費數分鐘。圖捕獲的成本主要來自兩個方面:一是必須執行一次急切模式(eager)前向傳播以編譯核心並為所需核心配置緩衝區;二是隨後重新執行 Python 程式碼的捕獲執行流程。
我們透過在引擎服務過程中「惰性捕獲(lazily capturing)」CUDA 圖來緩解啟動成本。我們追蹤每種組態配置,確保其在首次命中時進行急切預熱執行(eager warmup),在第二次命中時觸發圖捕獲與重播(replay)。該組態之後的所有執行便全數走 CUDA 圖重播。雖然惰性圖捕獲在服務啟動初期會對 p99 延遲產生一定影響,但它將長達數分鐘的密集預熱工作分散到數小時的正常運行中,效益極高。更短的啟動時間使我們能更有效率地擴展與管理嵌入服務部署。
惰性張量(Lazy Tensors)
在 CUDA 架構下,GPU 的運算是非同步執行的。由於啟動核心只是將其非同步排入串流(stream)中,主機端程式碼必須進行顯式同步才能讀出產生的向量結果。為了實現更高程度的並行性,並能在裝置端執行前一個批次的同時預先啟動後續批次,我們仰賴 LazyTensor 抽象層來追蹤運算數值。
LazyTensor 追蹤位於鎖頁記憶體(page-locked memory)中的主機緩衝區,以及透過事件(event)從裝置端複製資料的 cudaMemcpyAsync 操作。該複製操作在前向傳播於相同串流中啟動後隨即排入。由於複製操作必須等待該串流中所有先前的核心執行完畢,因此關聯的事件既追蹤了前向傳播的完成狀態,也標記了運算結果在 CPU 端的可用性。
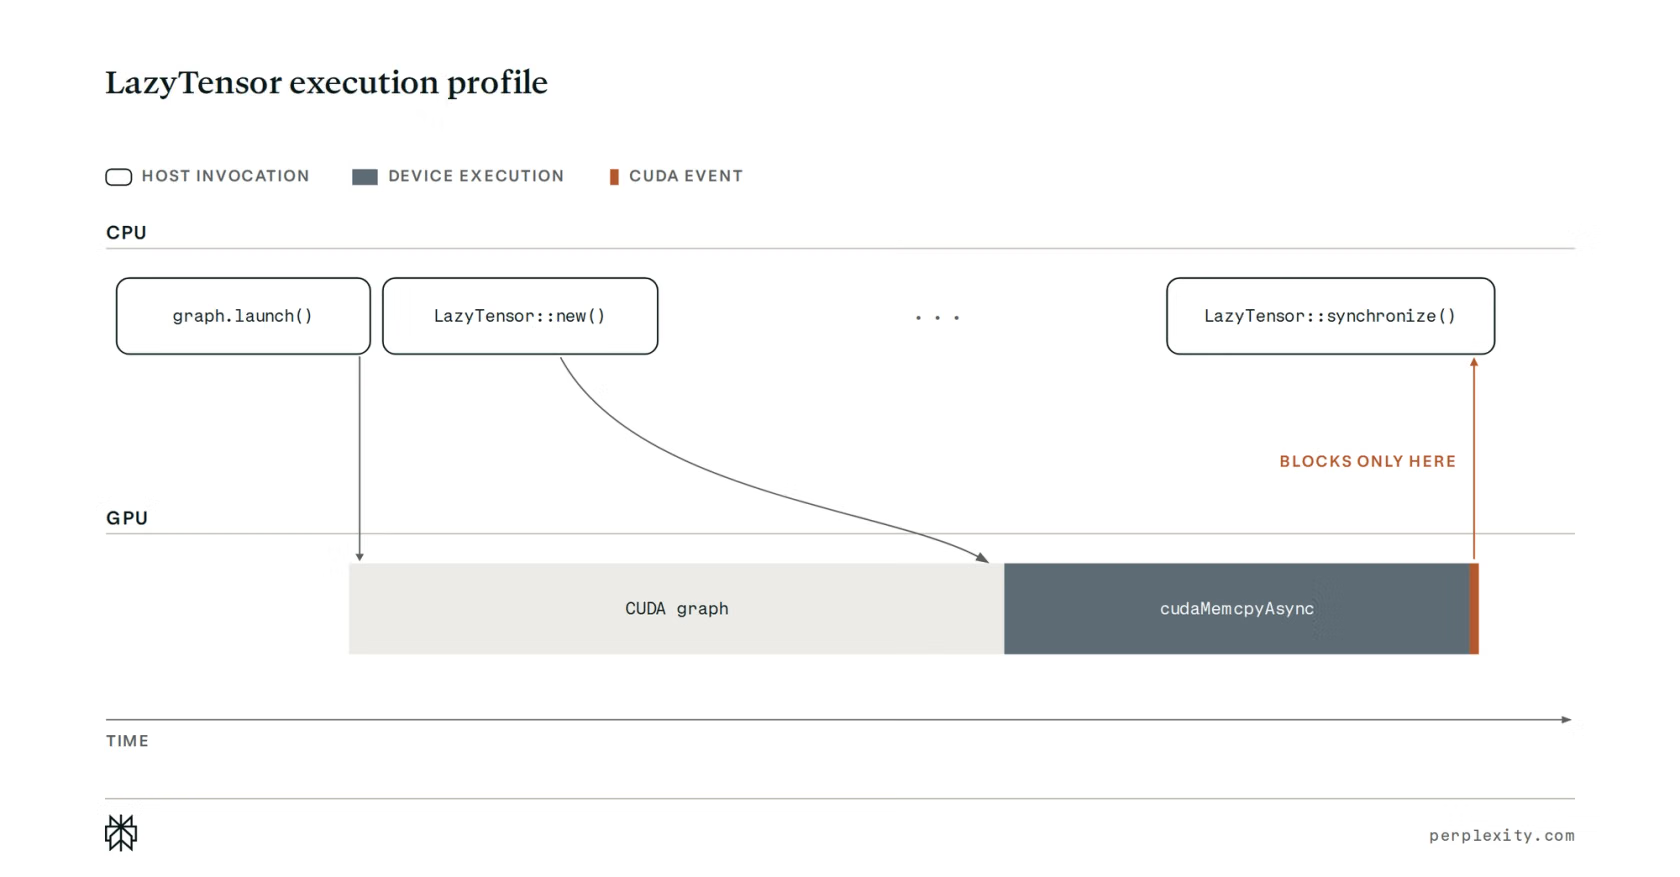
我們在 ROSE 編碼器引擎中運用 LazyTensor 來重疊 GPU 與 CPU 的工作。step() 呼叫不再於執行 CUDA 圖後同步阻塞等待其完成,而是直接由 step() 回傳一個 LazyTensor 來非同步追蹤結果。結合 CUDA 圖,這項機制助我們達成了極低的延遲與更高的吞吐量。
ROSE
我們將原本為 LLM 服務構建的 ROSE 引擎進行了改編,使其亦能處理嵌入模型的推論執行。為了將支援嵌入模型所需的工作量降至最低,ROSE 大量復用了 LLM 與嵌入模型之間的程式碼。舉例來說,pplx-embed 服務與 Qwen3.5 LLM 的解碼均透過完全相同的運算核心進行。這種程式碼共享架構使我們能輕鬆將最初由 LLM 微調而來的嵌入模型直接上線,用於原型設計、評估及生產環境推論。
在密集層(dense layers)中,由於各 token 向量均獨立處理,嵌入模型與 LLM 的推論運算完全相同。而在注意力機制層中,兩者的差異則透過引入對不規則輸入(ragged inputs)的支援來處理,並與 LLM 所需的分頁預填(paged prefill)與解碼機制並存。當部署嵌入模型時,我們不會實例化 KV 快取(KV cache),而是分發至支援 ragged 格式的注意力核心變體,以完全避免不必要的 padding 填充。相關的格式轉換與校準例行程式亦與 LLM 共享。
Ivy
Ivy 作為我們的推論 HTTP 代理層,在效能優化上也扮演著關鍵角色。由於生產環境中的請求載荷差異甚大,若將個別請求直接路由到單一副本可能會導致負載失衡。Ivy 會將大批次請求切分為多個區塊(chunks),並在各副本之間進行負載平衡,從而提升整體資源利用率並使延遲平滑化。我們近期研發並全面上線於 Ivy 的自研 Unigram Token 化(in-house unigram tokenization)技術,相較於市售現成 Tokenizer,更大幅度降低了延遲。
……但運算核心依然至關重要(...but the Kernels Still Matter)
ROSE 支援多種注意力後端。不同的運算核心可能適用於特定的問題規模。歷經持續演進,我們整合了 FlashInfer 2、FlashInfer 3 與 FlashAttention 4 核心來實作不規則注意力機制(ragged attention)。
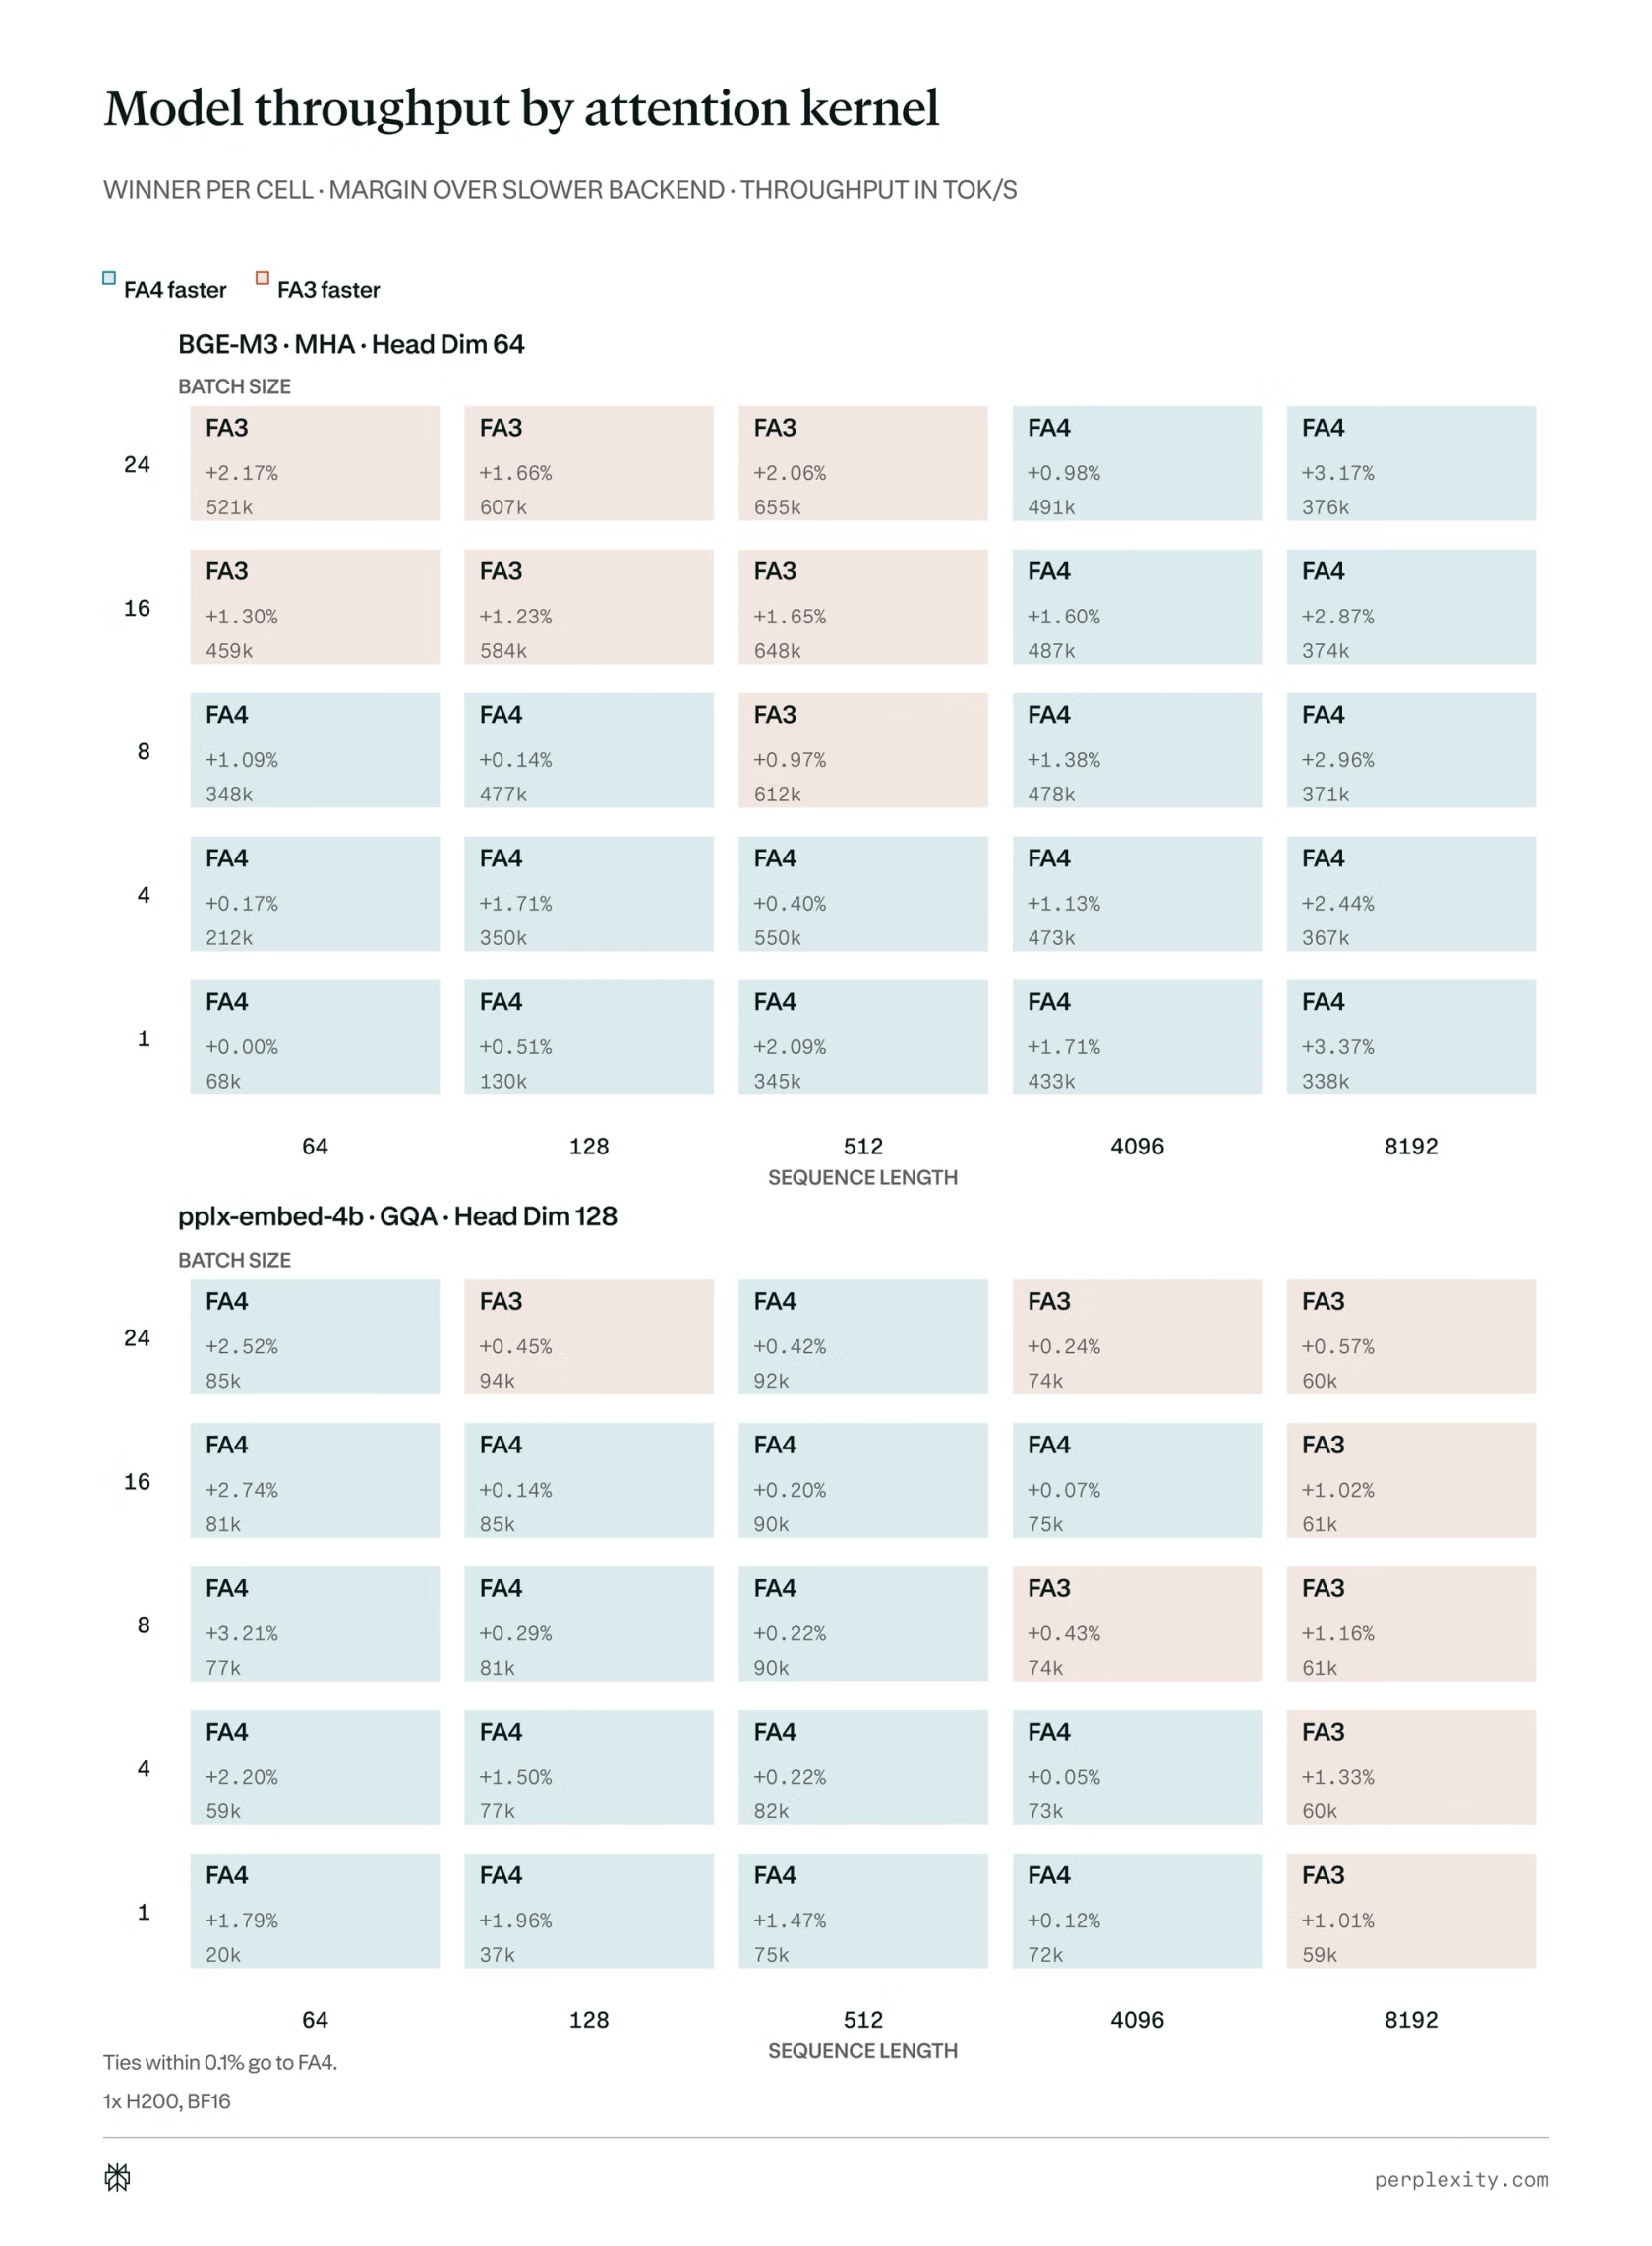
整體而言,我們觀察到 FlashAttention 4 速度更快。但在極長序列長度下,FlashInfer 3 在基於 Qwen 系列的模型上表現更為出色。由於效能與調校會因注意力頭(attention heads)的數量與維度而異,我們保持對多種組態的支援,並在實際服務時依具體情況動態選擇最佳核心。
基準測試(Benchmarks)
我們以 vLLM v0.22.0 作為基準對照組,在實際模型權重與源自評估資料集的輸入上,以 BF16 精度進行推論測試。所有計時測試前均進行預熱執行,並驗證其餘弦相似度(cosine similarity)的偏差在 0.1% 以內。
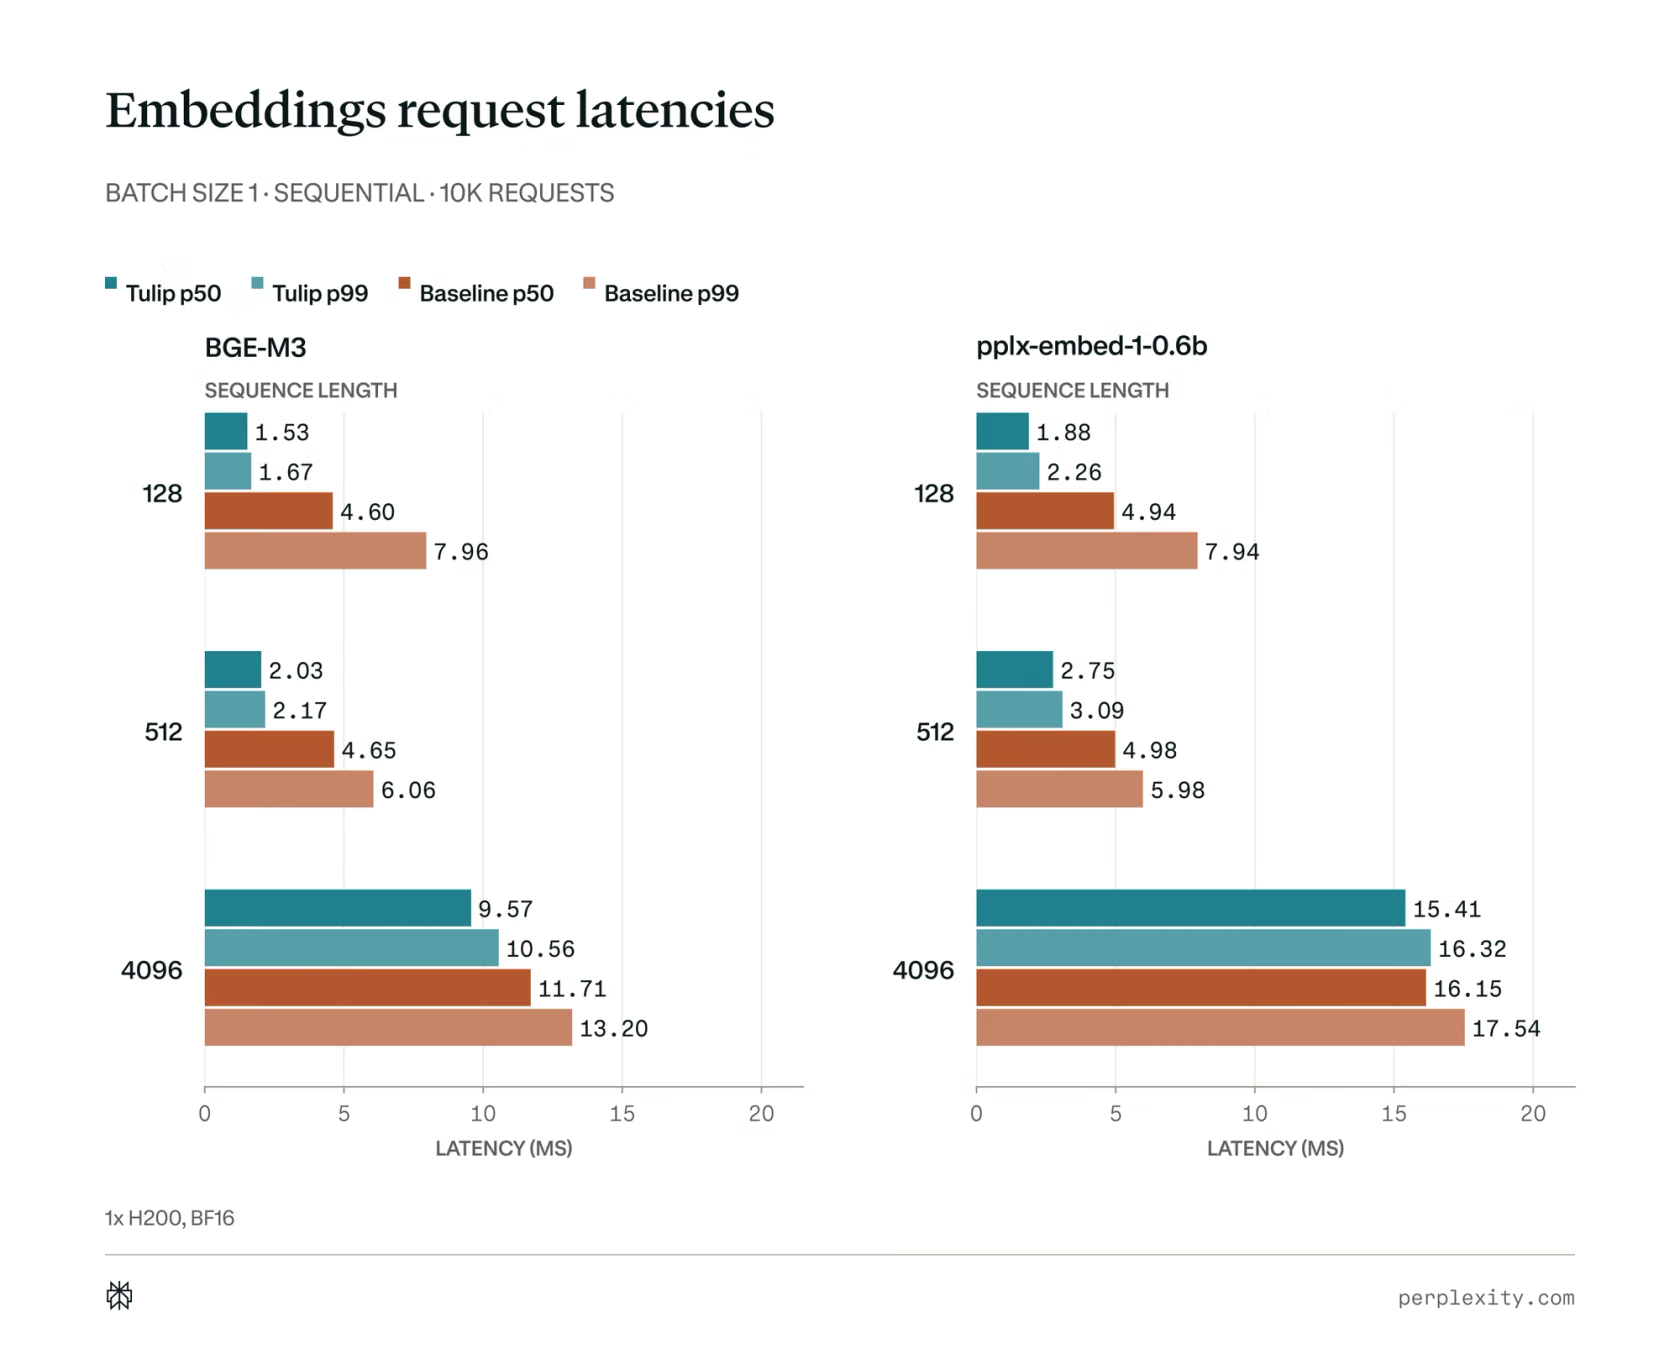
低延遲嵌入測試(p50 / p90 / p99 / max 毫秒)
我們測試了預先 token 化的單一請求批次(batch size 1)、完全循序請求,序列長度分別為 128、512 與 4096 個 token 的執行時間。
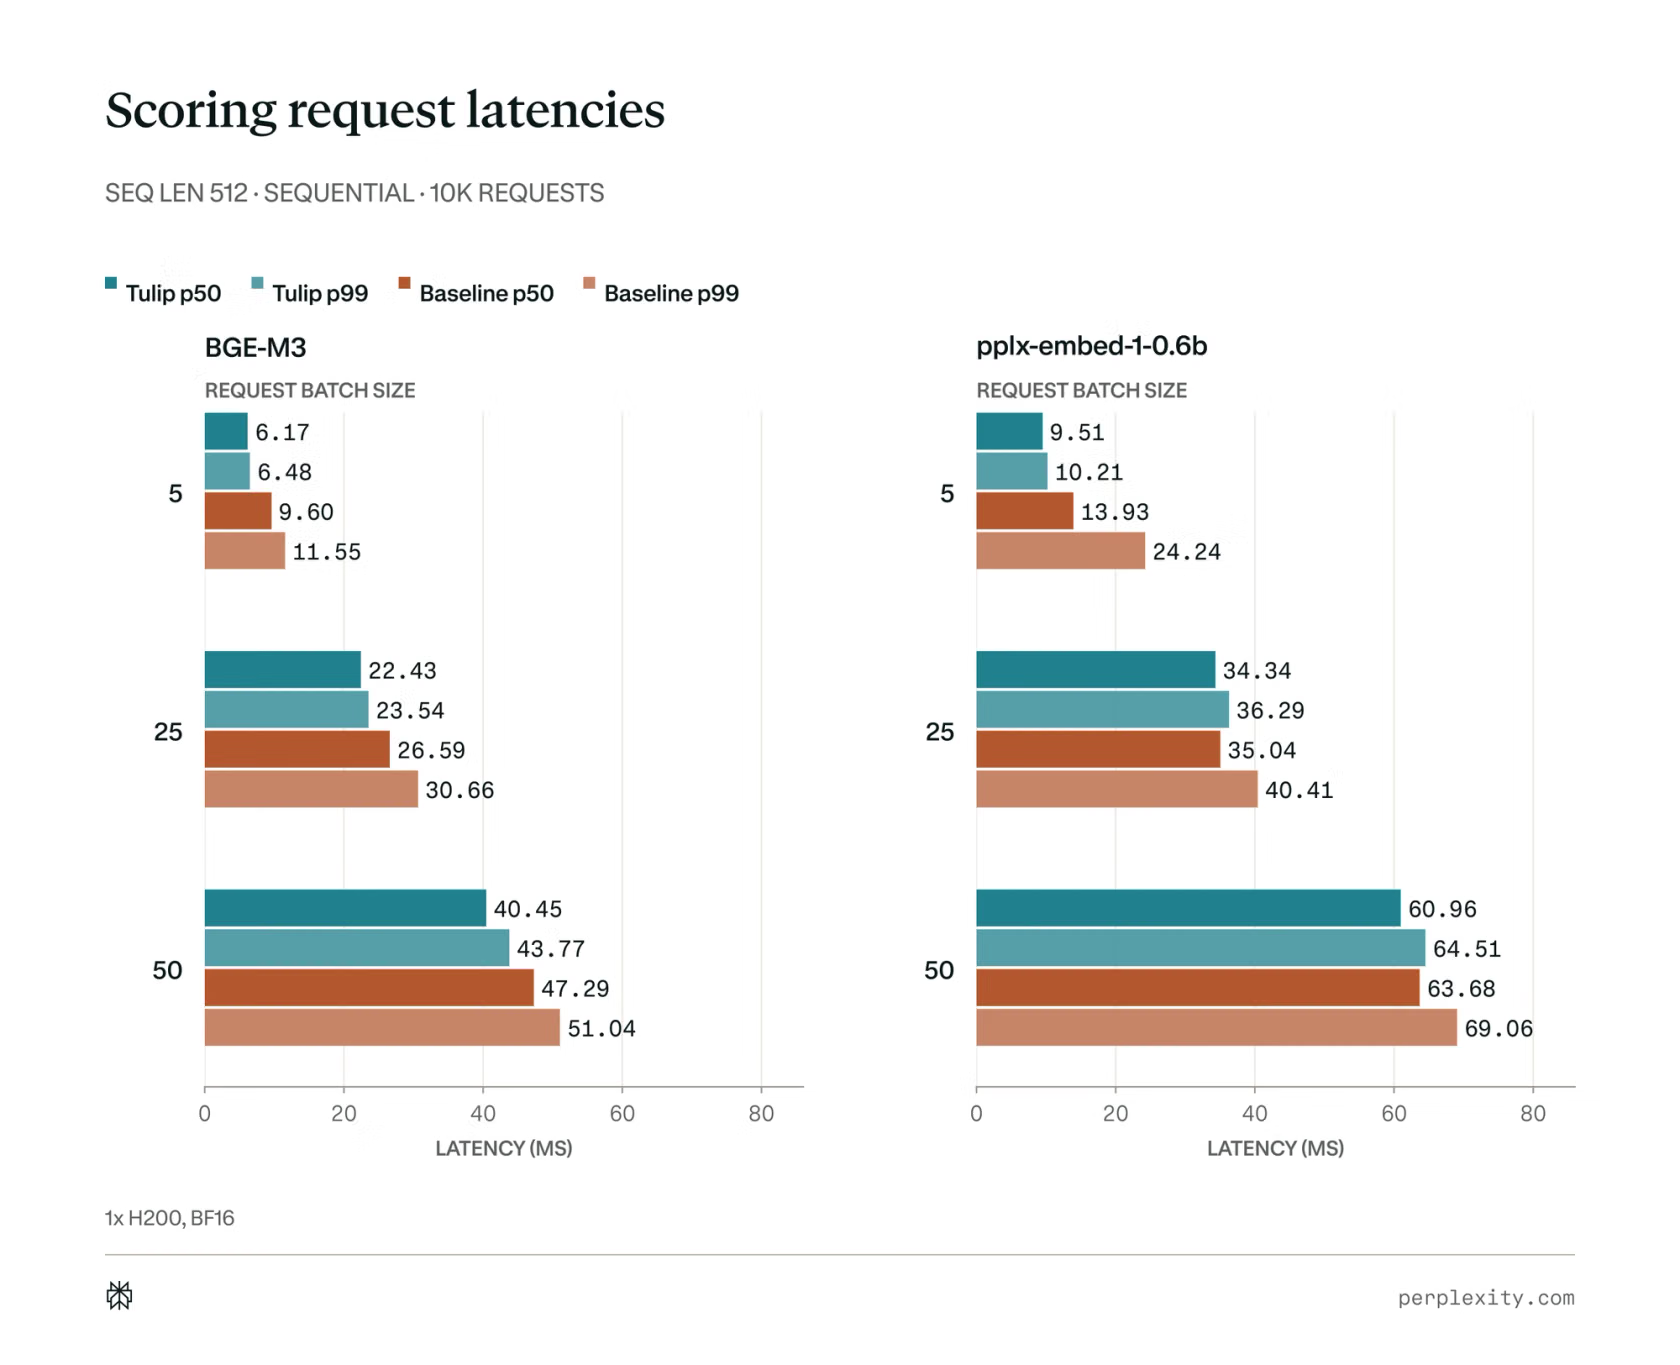
低延遲評分測試(p50 / p90 / p99 / max 毫秒)
預先 token 化之請求批次大小分別為 5、25 與 50,序列長度為 512 個 token。
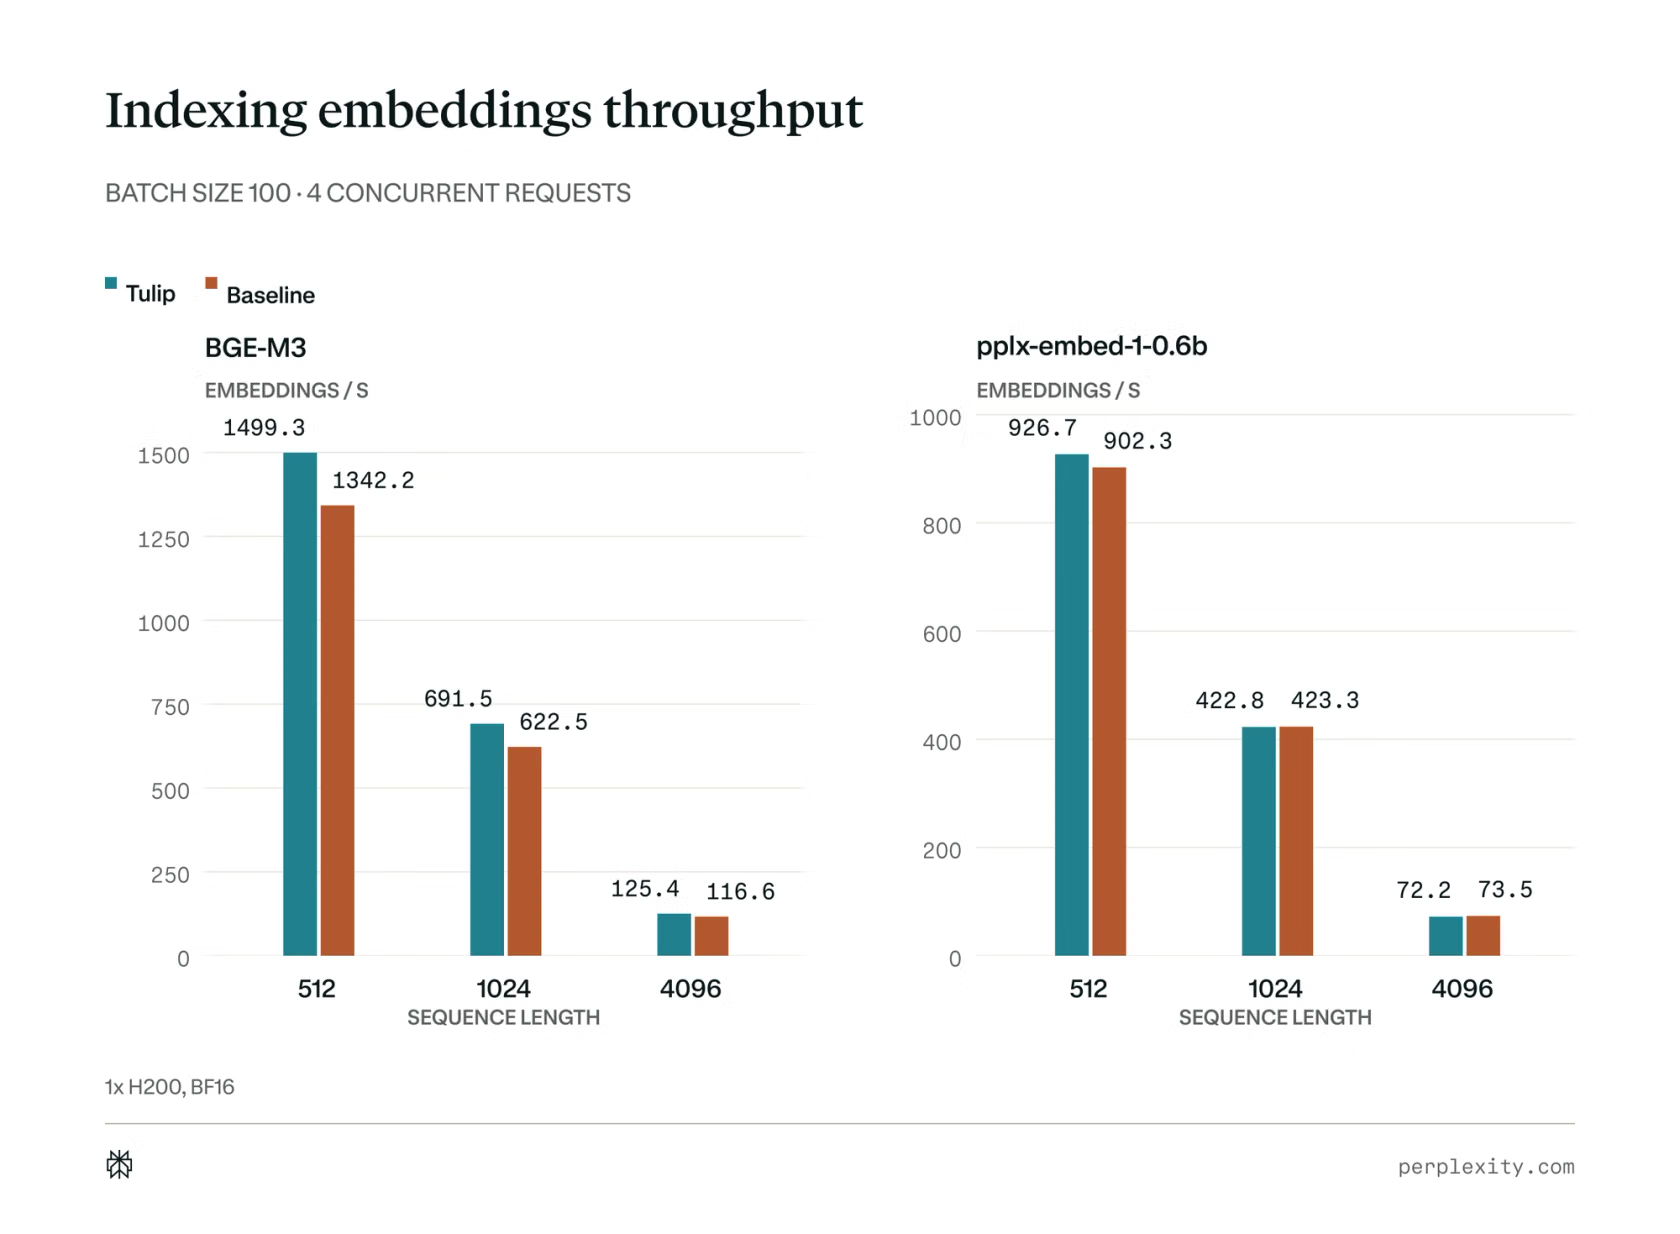
高吞吐量嵌入測試(emb/s,每秒嵌入數)
請求批次大小為 100,由四個並發程序提交請求,序列長度分別為 512、1024 與 4096 個 token。
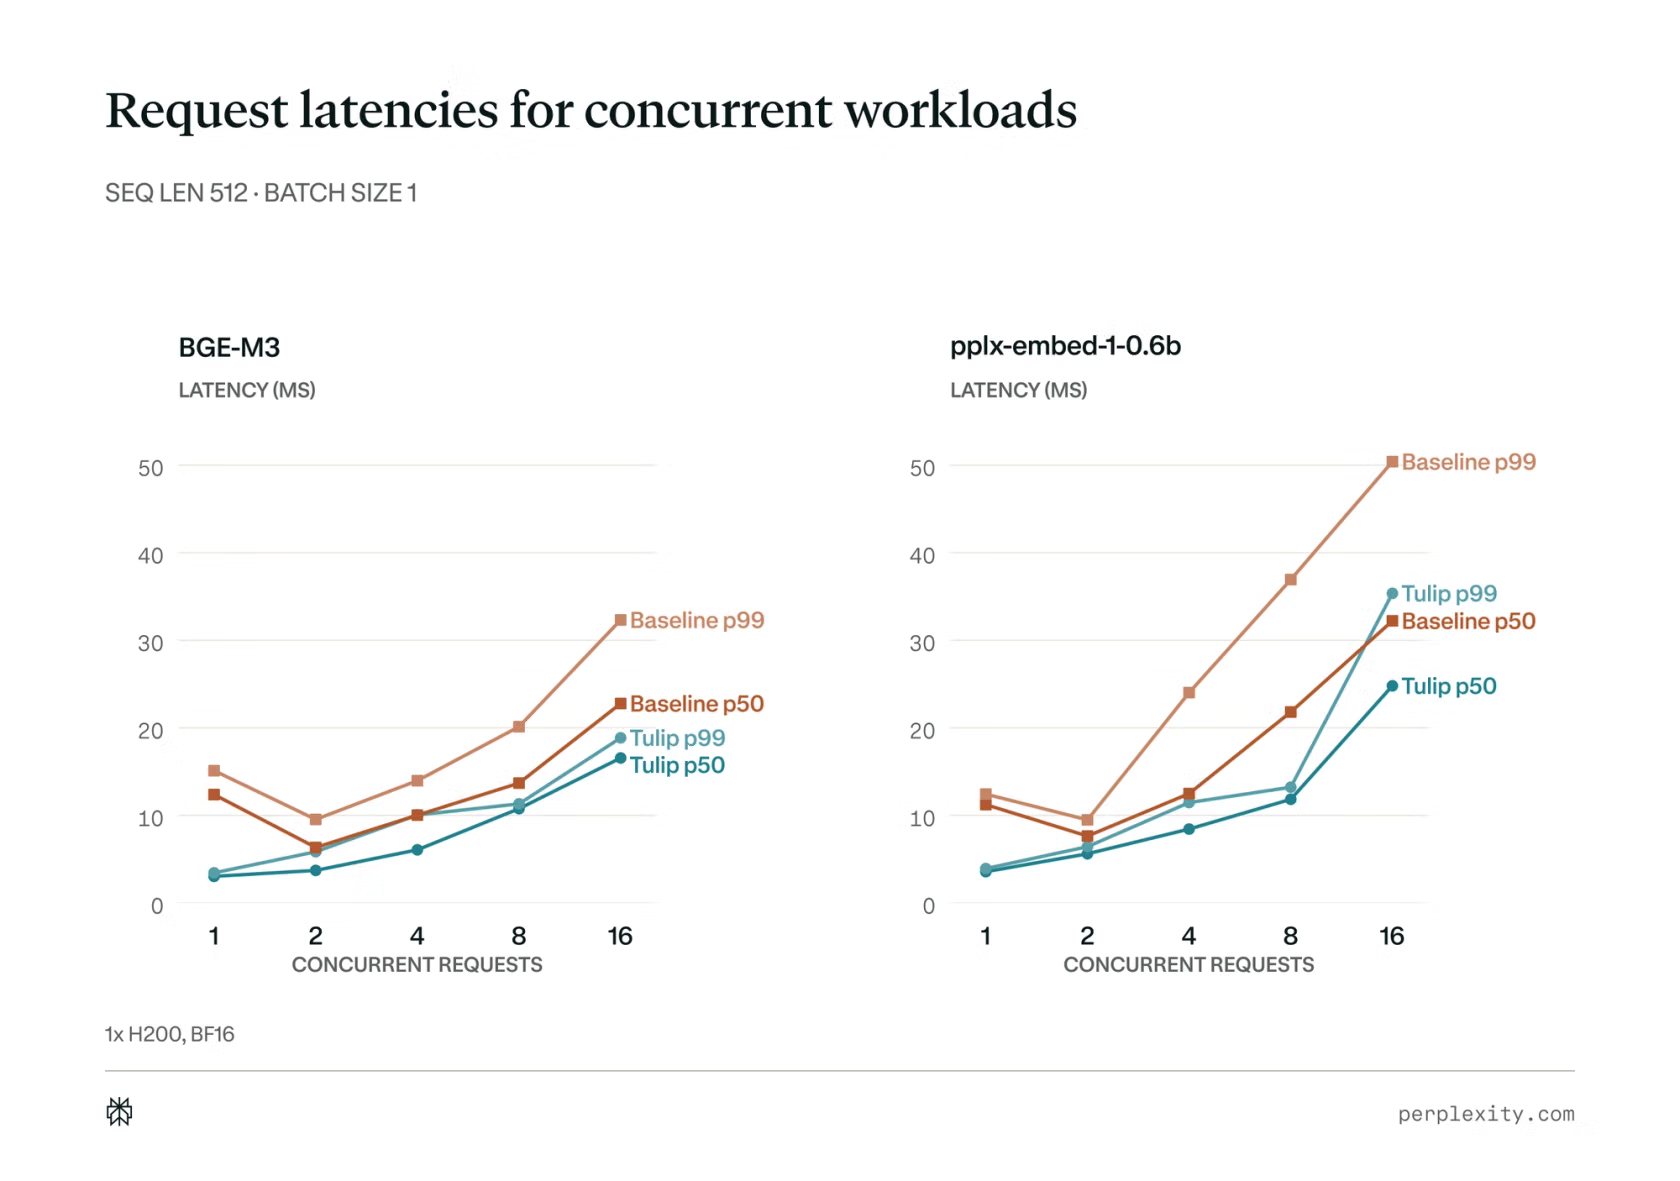
高並發嵌入測試(p50 / p90 / p99 / max 毫秒)
序列長度為 512,批次大小為 1,但我們同時發送 1、2、4、8 及 16 個並發請求。此項基準測試亦計入了透過 Ivy 進行 token 化的開銷,以及 Ivy 與 Tulip 之間的網路通訊傳輸延遲。
結論與未來展望(Conclusion and Future Work)
由 Ivy、Tulip 與 ROSE 所組成的服務基礎架構,使 Perplexity 能以更低的延遲和更高的吞吐量提供嵌入向量服務;相較於現成的解決方案,不僅搜尋更加精準,成本也顯著降低。
透過聚焦於特定模型並全權主導整個技術棧,我們獲得了在效能與靈活性之間取得最佳平衡的自主空間,將高度可復用且高效能的 Rust 原語與更具通用性的 Python 建模程式碼完美融合。許多開源推論引擎(如 vLLM、SGLang 與 TokenSpeed)也正逐步將 Rust 與 C++ 整合至其架構中。我們在過去兩年中持續深耕 Rust,並在效能與可維護性上收穫了豐碩的成果。透過將嵌入模型的大部分實作與 LLM 服務技術棧共享,我們在吞吐量方面獲得了顯著提升,同時無需為嵌入模型的維護投入龐大的額外工程心力。
隨著模型的持續演進,我們將不斷優化技術棧的每一層,以同時降低受限於 CPU 與受限於 GPU 的各類延遲。Ivy 與 Tulip 內部自訂的 gRPC 協定使我們能精準調校通訊細節以減少網路延遲,而 ROSE 則為提升運算吞吐量奠定了堅實基礎。此外,隨著生態系對自由執行緒 Python(free-threaded Python,無 GIL)的支援日趨成熟,我們將能進一步強化 Python 與 Rust 之間的互通性,消除更多的跨語言開銷。